Deine KI vergisst alles.
Vektor oder Graph: was ein Langzeitgedächtnis wirklich taugt.
Sprachmodelle haben ein Grundproblem: Jedes Gespräch beginnt bei null. Was gestern besprochen wurde, ist heute weg. Wer einen KI-Assistenten baut, der Kunden, Projekte oder Vorlieben kennen soll, braucht ein Gedächtnis außerhalb des Modells. Dafür konkurrieren gerade zwei Architekturen: Vektor-Datenbanken und Knowledge Graphs. Beide haben echte Stärken, beide haben blinde Flecken.
Das Kontextfenster eines Modells wirkt wie ein Gedächtnis, ist aber nur ein Arbeitsspeicher: Was gerade im Gespräch liegt, kennt die KI, alles davor nicht. Selbst riesige Kontextfenster lösen das nicht, denn irgendwann ist jedes Fenster voll, und alles hineinzukippen macht die Antworten schlechter statt besser. Warum das so ist, haben wir in Context Quality beschrieben. Ein Langzeitgedächtnis muss also außerhalb liegen: ein Speicher, aus dem sich das System vor jeder Antwort das Relevante holt. Die Frage ist nur, wie dieser Speicher organisiert ist.
Vektoren: das Gedächtnis nach Ähnlichkeit
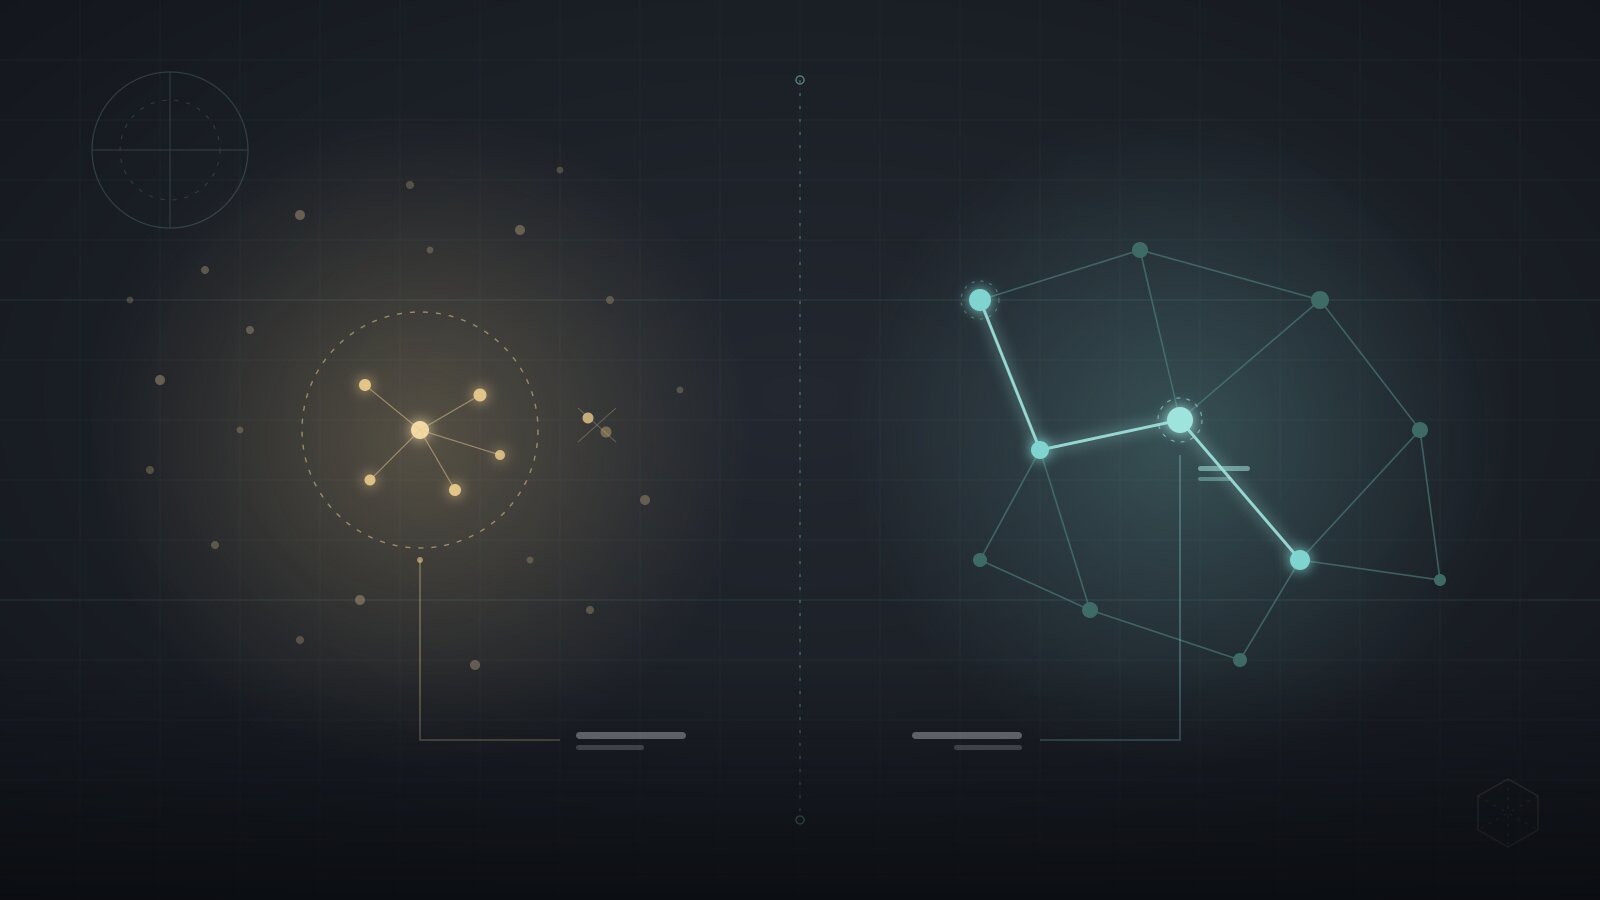
Der verbreitetste Ansatz: Jede Information wird als Zahlenvektor abgelegt, der ihre Bedeutung abbildet. Fragt der Nutzer etwas, sucht das System die Einträge, die der Frage inhaltlich am nächsten sind, und reicht sie dem Modell mit. Das ist die Technik hinter den meisten „Chat mit deinen Dokumenten"-Lösungen.
- Stärke, schneller Start: Eine Vektor-Suche ist in Tagen aufgesetzt, nicht in Monaten. Für erste Ergebnisse der mit Abstand kürzeste Weg.
- Stärke, versteht Bedeutung: Die Suche findet „Rechnung offen", auch wenn im Text „Zahlung ausstehend" steht. Genau das können klassische Stichwort-Suchen nicht.
- Schwäche, kein Zeitgefühl: Vektoren kennen kein „gilt seit" und kein „gilt nicht mehr". Hieß dein Ansprechpartner 2023 Müller und heute Meier, liegen beide Fakten gleichberechtigt nebeneinander. Welchen die Suche zieht, entscheidet die Ähnlichkeit zur Frage, nicht die Aktualität.
- Schwäche, Widersprüche stapeln sich: Einträge werden hinzugefügt, aber nicht korrigiert. Mit der Zeit sammelt sich Rauschen: veraltete Preise, alte Zuständigkeiten, überholte Entscheidungen. Je mehr Daten, desto öfter erwischt die Suche den falschen Stand.
- Schwäche, keine Verkettung: Fragen über mehrere Ecken („Welche Projekte betreut das Team, das Kunde X übernommen hat?") brauchen verknüpfte Fakten. Ähnlichkeitssuche findet einzelne Schnipsel, aber keine Zusammenhänge.
Knowledge Graph: das Gedächtnis nach Beziehungen
Der zweite Ansatz modelliert Wissen als Netz: Personen, Firmen, Projekte und Ereignisse sind Knoten, ihre Beziehungen sind Kanten. „Meier betreut Kunde X seit März" ist dann kein Textschnipsel, sondern eine Verbindung mit Gültigkeitsdatum.
- Stärke, Zeit ist eingebaut: Beziehungen können ein „gültig von, gültig bis" tragen. Das System weiß, dass Müller der frühere und Meier der aktuelle Ansprechpartner ist, und kann beides auseinanderhalten.
- Stärke, Denken über mehrere Schritte: Vom Kunden zum Projekt zum Team zur Zuständigkeit: Ein Graph kann solche Ketten ablaufen und Fragen beantworten, an denen Ähnlichkeitssuche scheitert.
- Stärke, nachvollziehbar und pflegbar: Fakten lassen sich gezielt ansehen, korrigieren und löschen. Bei personenbezogenen Daten ist das mehr als Komfort: Ein „Lösche alles zu Person Y" ist im Graph eine Operation, in einer Vektor-Wolke eine Suchaktion mit Restrisiko.
- Schwäche, deutlich mehr Aufwand: Jemand muss entscheiden, was eine Entität ist, welche Beziehungen es gibt und wie neue Informationen einsortiert werden. Das kostet Konzeption, Infrastruktur und laufende Pflege.
- Schwäche, Tempo bei tiefen Abfragen: Je weiter eine Frage durchs Netz wandert, desto länger dauert die Antwort. Bei großen Graphen wird das spürbar.
Ist das der nächste Hype?
Teils. Der Markt an Memory-Frameworks wächst gerade schnell, jede Woche verspricht ein neues Produkt das „perfekte Gedächtnis für deine KI". Das Feld ist jung, viele dieser Anbieter wird es in drei Jahren nicht mehr geben. Insofern: ja, da ist Hype dabei, und auf einen einzelnen Framework-Namen sollte man derzeit nichts Tragendes wetten.
Das Problem darunter ist aber echt und bleibt. Ein Assistent ohne Gedächtnis bleibt ein Werkzeug für Einzelfragen. Erst mit Gedächtnis wird daraus etwas, das sich wie ein eingearbeiteter Kollege anfühlt: Er kennt den Kunden, erinnert sich an die letzte Entscheidung und fragt nicht dreimal dasselbe. Wie Agenten grundsätzlich arbeiten und warum Kontext dabei alles ist, zeigt How Agents Work. Die Architekturfrage dahinter, Ähnlichkeit gegen Beziehungen, ist zudem älter als der aktuelle KI-Zyklus und wird ihn überleben. Wer die Prinzipien versteht, kann Anbieter wechseln, ohne von vorn anzufangen.
Und eine ehrliche Erwartung gehört dazu: Auch das beste Gedächtnis macht ein Sprachmodell nicht fehlerfrei. Es erinnert sich meistens richtig, nicht immer. Wer 100 Prozent braucht, braucht eine Datenbank mit fester Logik, keinen KI-Assistenten.
Wann nimmst du was?
Die Entscheidung hängt weniger vom Trend ab als von zwei Fragen: Wie stark ändern sich deine Fakten, und wie vernetzt sind sie?
- Vektor reicht, wenn du Wissen durchsuchbar machen willst, das sich selten widerspricht: Dokumentation, Wissensdatenbank, Support-Artikel, Produkttexte. Schnell gebaut, gut genug, günstig.
- Graph lohnt sich, wenn Beziehungen und Verläufe zählen: Kundenhistorie, Zuständigkeiten, „wer hat wann was entschieden", Systeme mit vielen sich ändernden Fakten. Der Mehraufwand kauft dir Aktualität und Nachvollziehbarkeit.
- Hybrid ist oft die Praxis: Vektor-Suche für den Inhalt von Gesprächen und Dokumenten, ein strukturierter Speicher für die harten Fakten daneben. Viele reife Systeme landen genau da.
- Und manchmal reicht weniger: Ein Assistent, der sich zehn Dinge über einen Nutzer merken soll, braucht weder Vektor-Datenbank noch Graph. Ein strukturiertes Profil mit festen Feldern tut es auch. Die Frage ist wie immer nicht „Was ist der beste Ansatz?", sondern „Wie viel Gedächtnis verdient dieser Anwendungsfall?".
Ein Wort zu den Kosten: Fast alle Anbieter lassen dich kostenlos starten, und genau so solltest du auch anfangen. Ab ein paar tausend Nachrichten im Monat wird der Memory-Layer aber ein eigener Kostenpunkt, denn im Hintergrund liest ein Sprachmodell mit und sortiert ein. Spätestens dann lohnt der Blick auf Selbst-Hosting oder eine schlankere eigene Lösung. Und weil ein Gedächtnis naturgemäß persönliche Daten sammelt, gehört die Frage „Wo liegen diese Daten, und wie lösche ich sie?" an den Anfang der Auswahl, nicht ans Ende.
Vektor-Gedächtnis ist schnell gebaut und versteht Bedeutung, kennt aber weder Zeit noch Zusammenhänge und verrauscht mit wachsender Datenmenge. Ein Knowledge Graph kann beides, kostet aber spürbar mehr Aufbau und Pflege. Am Hype um Memory-Frameworks ist etwas dran, das Problem ist echt; wetten solltest du trotzdem auf die Prinzipien, nicht auf Produktnamen. Und nicht jeder Anwendungsfall verdient die große Lösung.